2026年11月13日
昨日はAI エージェントを様々な実験装置と組み合わせて、希望するDNA実験を自動で行い、解析するAI-Nativeシステムの論文を紹介した。生命科学部門では一番乗りの論文として Nature に取り上げられ、私も紹介したが、あまり感動する論文ではなかった。と言うのも、化学ではAI-Nativeな実験システムは存在しているようだし、これまでのAIエージェントにコード作成エージェントなどを加えて機械とつなげただけで、大きな革新を感じなかった。AIで出遅れた我が国がフィジカルAIと唱えてこの論文と同じような目標を目指しているのなら心配だ。
一方、今日紹介するNew Yorkゲノムセンターからの論文は、single cell RNA sequencing の情報処理方法に関する新しい方法で、数理に疎い私には、実際の処理についてはほとんど理解の外にある研究だが、目的や結果は十分理解することができ、感動した。昨日紹介した論文のようにいつかは誰かがやるという話ではなく、研究者のアイデアと強い意志に基づくオリジナリティーが感じられる論文なので、数理処理は理解していないことを断った上で紹介することにした。タイトルは「Reconstructing developmental and disease progression with sample-level embeddings(発生と病気の進行をサンプルレベルのエンベッディングから再構築する)」で、11月9日 Cell にオンライン掲載された。
この研究では、Covid-19感染者の末梢血、アルツハイマー病 (AD) の大脳皮質、そして様々なステージのゼブラフィッシュ胚から得られた single cell RNA sequencing (SCRS) データを、既存のデータベースから取り出し、これを材料に全く新しい方法のデータ処理法を開発している。
SCRSデータは病気の理解を大きく変えていることは何年もに渡って紹介してきた。ただ、データ処理は細胞間の関係や変化が中心で、ADと正常を比較すると言った限られたカテゴリーを比べる目的で使われている。そのため、AD患者さんの脳細胞は同じものとして解析結果をプールすることも普通に行われている。しかし、それぞれの細胞は一人一人の患者さんから採取されたもので、患者さんはADと言うラベルはついていても一人一人異なる。この研究では、SCRSデータから、この一人一人の患者さんの違いを、細胞データの特徴を抽出してエンベッディングすることで見える化する方法を開発した。
方法だが、通常のSCRSデータは採取した組織の細胞の遺伝子発現の違いでベクトル化している。この同じデータを、病気やその重症度を教師として病気と正常が分かれるよう新しい座標軸に投影し、病気、重症度、等を決める遺伝子の違いが強調されるような処理を行っている。これに部分最小二乗法を使っているが、説明は私には荷が重い。
さて、こうして同じデータから2種類のエンベッディングを行ったあと、これをこの研究室で以前開発された2種類のエンベッディングでの細胞の関係を統合するWNNと呼ばれる方法を用いて、通常のSCRCデータに疾患による違いが重なった統合細胞分布マップが作られる。
次がこの研究のハイライトで、こうして出来た病気による違いが重ねられた細胞のエンベッディングを、細胞が由来する一人一人の個人のエンベッディングを造る方法で、実際には細胞が分布する座標の中から、5000箇所の目印(遺伝子発現が異なる細胞に対応する)を抽出し、個々のサンプルデータを、この目印の近くにどのぐらい似た細胞が集まっているのかを計算して、5000次元のエンベッディングに変換し、一人の個人の特徴が表現されるようにしている。例えばCovid-19の末梢血だと、正常の単球に近い状態が健常人では高く、患者では低いが、炎症性単球に近い状態は患者では高く、正常では低く出る。しかも、正常人、患者それぞれに、数値に幅があり、これにより個人個人の特徴を捉えることができる。実際の研究では、一人の個人から5000個の細胞を解析することは難しい。ただ、こうして目印細胞を決めてこれを元に個人エンベッディングを造ることで、この問題が十分解決できることも納得できる。
Covid-19感染データから各個人を分布させ、個人の差が明確になる座標を探すと、感染のありなしだけでなく、軽症から重症への変化、更には発症後の日数などの座標に沿って、各個人が見事に並んで分布することがわかる。即ち、感染者、非感染者ではなく、個人個人の差がとられられたことがわかる。この差を手がかりに、各座標を反映する遺伝子や細胞を特定することも可能で、個人個人の差を大事にすることで、これまで気づかれなかった分子機構に迫ることも出来る。
同じ解析を今度はADの脳細胞で行い、患者間の病理学的な差を見事に反映した個人のエンベッディングが可能であることを示している。遺伝子的にも、この進行度はアミロイドやリン酸化Tau、そしてミクログリアの活性化などを反映することも示している。
最後にゼブラフィッシュの発生段階を調べているが、この場合は発生時期の異なる胚が個人に相当し、発生時点が病気に相当する。その結果、通常時間とステージング表だけでは決めきれない胚の発生状態を見事に捉えられることも示している。
結果は以上で、これまで個人個人の違いを消すようにしていた情報処理から、個人の違いを浮き上がらせることの出来る情報処理への発想の転換が素晴らしく、情報処理法については全くわかっていないのに、むちゃくちゃ感動した。
2026年11月12日
タイトルにあるAI-Nativeとは、AIが人間を助けるという段階から人間が最初のアイデアを出せば後はAIがシステムを動かして問題解決を進めるというシステムをさす。このブログでも、今年5月に、様々な分野で急速に導入が進むAgentic AI (AIエージェント) を実験の計画から評価までのほとんどの段階で利用して創薬に用いる論文を紹介した(https://aasj.jp/news/watch/28906 )。ただ、これまで紹介してきたAIエージェント論文は、実際の実験でアイデアやプロトコルを試すというパートについては、人間が行ってきた。
これに対して今日紹介する中国・上海交通大学からの論文は、実験まで人間の力が必要無い AI-Native 研究システムを構築できるという論文で、11月4日 Nature にオンライン掲載された。タイトルは「An AI-native experimental laboratory for autonomous biomolecular operations(生物分子実験を自動で行うAIネーティブ実験室)」だ。
これまでのAIエージェントでは、問題に対して文献に基づいて実験方向を決めてから、プロトコルを作成し、これに基づいて実験が行われた後、またAIが評価や仮説を立て、これをまた文献などから評価する過程が繰り返される。この研究では、エージェントから出てきたプロトコルに沿って、試薬を集めるとともに、プロトコルを実行するためのプログラムコードを作成し、それに基づいて様々な実験器具を操作するところまで自動で行う。
この研究ではDNA実験に焦点を当てており、ピペットなどのリキッドハンドリング、インキュベーター、シークエンサー、PCR器機、磁石による精製、等を自動で操作するよう計画して、DNA合成、増幅、転写、配列決定などが自動で行える。写真を見てみると6台ほどのベンチに様々な機械が設置されており、それぞれをロボットアームでつなぐという構造になっている。
一般の人から見ると大変なことのように見えるが、Claude Code のように、アイデアがあればプログラムコードをどんどん作れる時代、これをハードにつなぐこと自体はそれほど大変ではないと思う。その意味で、化学合成などより複雑な生物実験でAIネーティブシステムの一番乗りを目指した感がする論文だ。
実際に行った実験をいくつか上げているが、
等を簡単な命令だけで全てやれることを示している。
いわゆるフィジカルAIが正に実現しているわけだが、このブログで紹介したいくつかのAIエージェント論文と比べると、6台のベンチと移動アームを設定し、実際に操作できるようにしたこと以外、特に新しいとは感じない。また、良く読んでみると、実験自体はかなり条件を絞って行っている。例えばガン遺伝子変異の特定では、図で見るとアダプターを付けてライブラリーを造るというように、全エクソームについて行っているように見えるが、実際には300程度のベースで K-ras が存在する領域だけを標的にして、Ras 変異の種類を特定する研究になっている。Ras に対する薬剤適用の可否には使えるが、ガンの遺伝子診断としては初歩の初歩で、これでは臨床の役に立たない。
この論文を読んで感じるのは、我が国の強みとして政府からも聞こえてくるフィジカルAIというお題目の問題だ。車の運転にしても、我々人間はフィジカルな領域を計画し、操作してきている。この人間をAIで置き換えるためには、やはりAIそのものの競争になると思う。チューリングの偉大さは、ヴィトゲンシュタインやゲーデルの提起した「正しい論理?」の問題を、「物理世界を動かせる論理が正しい」と言い放ったことで、結局競争はフィジカル自体とコードを供給するAI自体に帰着するように思う。
DNA実験領域でフィジカルを考えると、DNAシークエンシングや合成など様々な作業は各実験室から離れて、効率を求める外注システムに変わっている。従って、AIエージェントも、全てを実験室内で行えるという条件はあまり意味がないように思う。自分のガンに関する様々なデータは専門家に解析して貰ったが、私も自分のパソコンでどこまで可能か、GPTの助けを借りて行ってみた。するとGPTはMacのコマンドラインを使って、必要とあればパイソンのコードを作成して、エクソームから変異遺伝子を特定し、その中でガンで発現の高い変異をリストして、さらに私のMHCとアフィニティーの高いワクチン候補を探索することを私に可能にしてくれた。専門家の結果と比べると3割ほどの正解率だが、それでも全く自分で解析したことがなかった私に的確な指示で、ここまでたどり着かせてくれた。そう考えると、実験室にAIで動く機械を設置することが AI for scientist ではない。一つの研究室が1000人規模のゲノムを扱える時代に、AIエージェントをどのように導入するか、またその意味について考えていくことが勝負の分かれ道になる様に思う。
2026年11月11日
今年国際的取り決めとして名前を変更した病気がある。男性ホルモンが過剰になり、無月経や生理不順、排卵障害を来す病気で、卵巣に多数の嚢胞が発生することから、多嚢胞性卵巣症候群と呼ばれていた。ところが、この名前だと卵巣障害と間違うということで、ホルモン異常を強調した多内分泌代謝性卵巣症候群 (PMOS) という名前に変更することが、今年の6月に決まった。特に代謝が名前に入ったのは、インシュリン抵抗性や脂質異常が認められるからだが、診断基準としては、アンドロジェン過剰、排卵障害、多嚢胞性卵巣が基準として使われる。
今日紹介する中国・北京大学からの論文は、PMOSを食物繊維摂取により細菌叢の中にテストステロン分解細菌を増やすことで治療できることを示した研究で、読んでみるといくつか問題は感じるが、本当なら婦人科領域では重要な研究だと思う。タイトルは「Targeting hormone conversion through dietary fiber improves polyendocrine metabolic ovarian syndrome(多内分泌代謝性卵巣症候群を食物繊維でホルモンを転換することで治療できる)」だ。
このグループは元々腸内細菌叢による胆汁酸などの代謝について研究しており、今回の研究もその延長にある。即ち、男性ホルモンの過剰分泌がPMOSの一つの原因なら、腸内で分解してしまえばいいのではと着想した。実際、原因は調べられていないが、PMOS患者さんでは食物繊維が少なく、また食物繊維摂取で症状が軽減するという報告も出ていた。
研究ではまず100人のPMOS患者さんにイヌリン、難消化性デンプン、βグルカンをミックスした食物繊維を12週間摂取させ、PMOS症状改善が見られるかを調べた。すると、コントロールと比べ生理の回数が12週目で2倍に増え、PMOSで見られる多毛症も軽減した。これに対応するホルモンの変化を調べると、テストステロンとその前駆体A4の血中濃度の低下が認められた。これと平行して、便中のA4とテストステロン濃度も減少しており、想定したように腸内でテストステロンz前駆体A4が分解されることで、男性ホルモン過剰が軽減される予想と合致した。
ここまで来ると、後は分解するバクテリア探しで、食物繊維摂取で増加する様々な細菌とA4を混合する実験から、Bacterioides xylanisolvens (BX) と呼ばれる細菌だけが強い分解能を持つことを突き止める。そして、マウスにdehydroepiandrosterone(DHA) を投与して誘導するPMOSをBXが抑えることができること、そしてBXにより血中及び便中のテストステロンやA4が低下することを確認している。
あとは、BXがA4分解するときの分解過程と、酵素を特定している。結果、BXにはA4から coproandrosteron と言う中間体までの分解過程に関わる酵素CASが存在する。この酵素が欠損したBXではDHAによるマウスPMOSを治療する能力が失われる。元のPMOS患者さんの治験に戻ると、食物繊維を摂取した群の便ではCASの濃度が上がっていることが観察できるので、マウスだけではなく人間でも同じ過程でテストステロンが分解されていると結論している。
最後にA4からできた coproandrosteron の最終処理についても調べており、BXにはこれ以上分解する能力は無いが、ビフィズス菌など他のバクテリアで完全に分解されることも明らかにしている。
結果は以上で、臨床結果から発したおもしろい研究だが、読んでみて2つの重要な問題を感じた。まず、A4は女性では主に副腎で造られるが、当然最初は血液に分泌され、卵巣や脂肪組織でテストステロンになる。この論文が正しいとすると、合成されたA4のうち多くが腸管内に排出されるが、再吸収されることで過剰状態が維持されており、この排出再吸収部分を細菌に処理させることでテストステロン過剰が抑えられる事になる。しかしこの排出再吸収について一切議論されていないのは問題になる。と言うのも、男性ではA4は精巣でも造られるので基本的に副腎由来のA4が減ると女性化する心配はないと思うが、副腎由来分も血中のA4維持に関わると考えられるので、食物繊維をとるとこの分のA4が減ってしまうと何らかの変化が起こる気がする。いずれにせよ腎臓でのグルコースの再吸収と同じように、ホルモンが腸管から再吸収されるというのはどうも解せない。
2026年11月10日
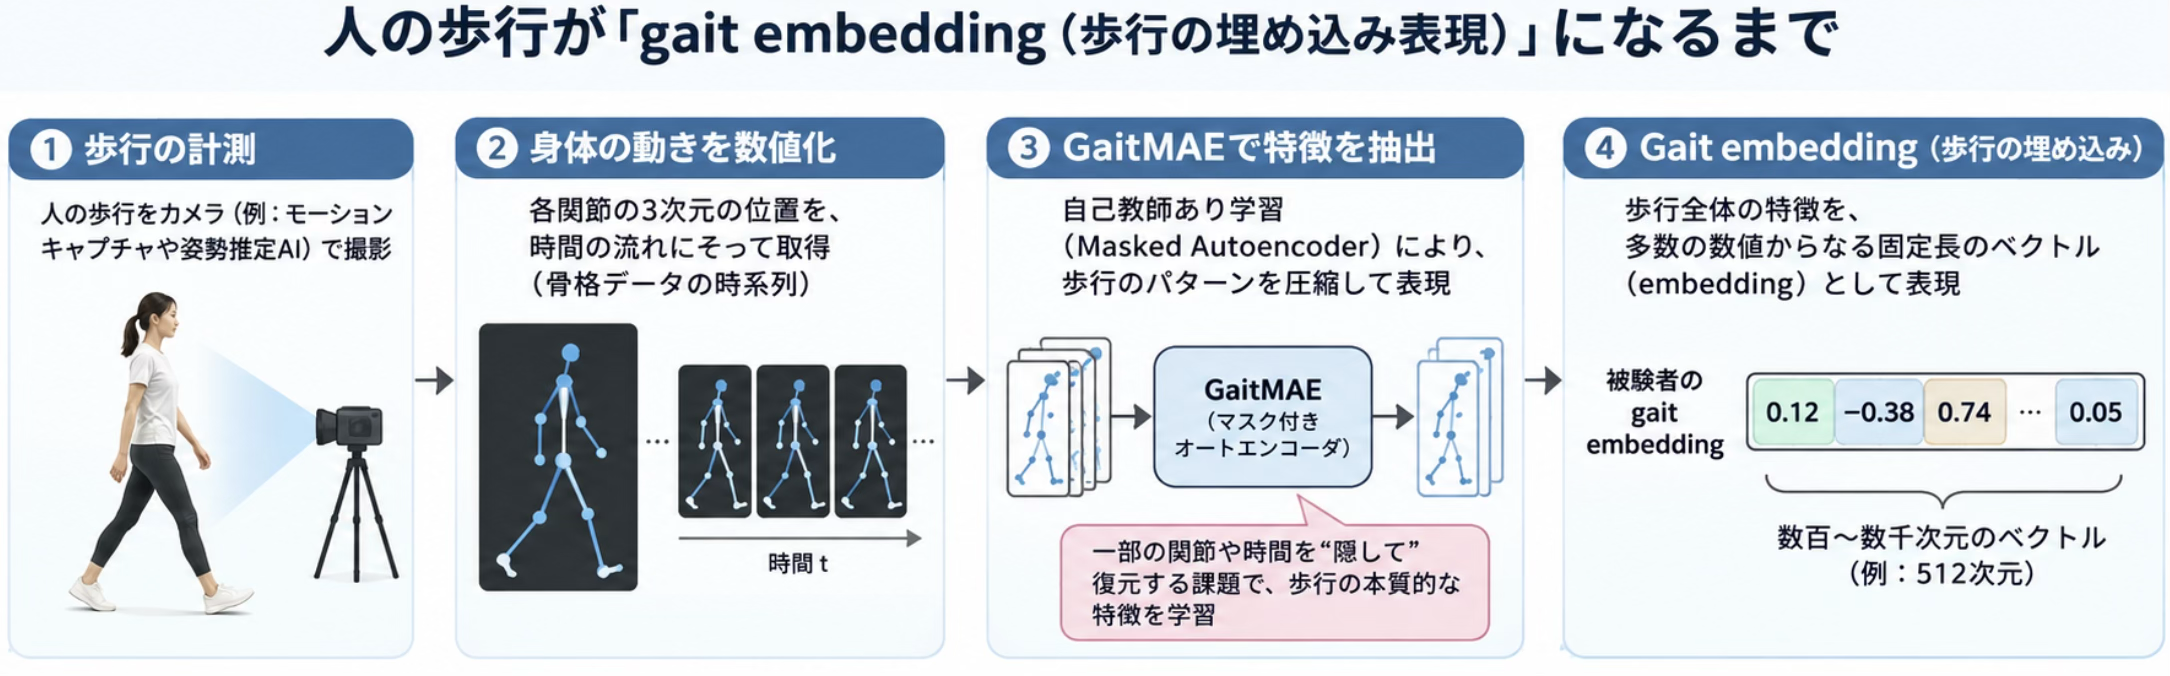
従来からヒトの歩く速度など様々な運動機能は健康指標として利用されてきた。しかし、筋力や時間と言った運動指標を、運動全体を表現する指標に変えることで、健康指標としての価値をより高めることができる。そのため、歩いたり飛んだりといった様々な運動をカメラで捉え、これをLLMでエンベッディングする Gait embedding が行われている。歩行についてエンベッディングが行われるまでの過程についてGPTの作成した図を以下に掲載しておく。
何次元のエンベッディングを用いたのかは把握していないが、こうしてそれぞれの個人の Gait embedding が多次元潜在空間に分布するが、今度はこのエンベッディングに例えばBMIという指標を教師として、各次元の重みを変化させてBMIの数値上にリニアに分布するようモデルを学習させる。もし gait embedding 空間にBMI情報が潜在的に影響しておれば、このモデルは新しい gait embedding からBMIを予測する事ができるようになる。こうして様々な形質を調べると、BMIはかなり高い精度で gait embedding と相関することがわかる。太れば運動機能が落ちるということを正確な指標として表現できたことになる。BMIと比べると、年齢との相関はかなり低い。これも年齢だけでは歩きかたは予測できないという実感に合う。
この研究では、同じようにして多くの性質や病気などの臨床レコードと gait embedding の相関を調べている。やはり最も相関するのは肥満や内臓脂肪、あるいは筋肉量と言った指標になる。ただ調べていくと、例えば腎機能を示すクレアチニン、肝臓実質の状態についてのSoS指標などは高い予測率になり、gaitに影響していることがわかる。
もちろんBMIと内臓脂肪と gait embedding が相関しているだけで、他の指標はBMI等との相関だけでないかという検討も行い、年齢、身長、BMIとは明らかに別の指標として利用できることを確認している。
おもしろいのは様々な病気との相関で、高い相関を示す病気、例えばうつ病や十二指腸潰瘍などが特定されるが、多くの場合は、例えばヒスタミン再吸収阻害剤やプロトンポンプ阻害剤と言った薬剤との相関を反映していることも示された。
元々小さなモデルなので、それぞれの相関に身体のどの部分の動きが重要かも、各運動部分をエンベッディングから除去することで分析することも出来る。結果、多くの性質で gait embedding との相関は足の動きが貢献していることがわかった。
以上が結果で、歩き方から健康がわかるというだれもが感じることを、臨床指標として使える様にするためにもAIが素晴らしい働きをするという話だ。
2026年11月9日
今日紹介するミシガン大学からの論文を読んで初めて知ったが、乾癬治療でTNFやIL-17を抗体で抑制する治療によって、今度は多様な湿疹が発生する Paradoxical eczema と言う病態があるようだ。この患者さんの皮膚からバイオプシーで組織を採取し、様々なオミックスを組み合わせて解析し、納得できるシナリオに至ったのがこの研究で、11月4日 Science Translational Medicine に掲載された。タイトルは「TWEAK signaling drives the transition from psoriasis to atopic dermatitis–like inflammation in paradoxical eczema (Tweakシグナルが乾癬をアレルギー性皮膚炎に似た炎症に転換するのがParadoxical eczemaだ)」。
炎症を抑える抗体が違う炎症を誘導するという皮膚科ならではの興味ある現象なので、これまでも盛んに研究されており、Th1/Th17型の炎症を抑えることでTh2/インターフェロン型炎症にスイッチするのだろうと考えられてきた。このメカニズムを明らかにすべく、正常人、乾癬、アレルギー性皮膚炎 (AD) 、そして Paradoxical eczema (PE) の患者さんの病変組織を採取、おもに single cell level の解析を行ったのがこの研究だ。
この結果、PEの細胞構成は乾癬とADの中間に位置するが、遺伝子発現から見ると乾癬でもADとははっきりと異なる、特に好中球の反応、免疫反応、そして自然免疫の強い遺伝子発現パターンを示すことが明らかになった。その中でも、タイトルにあるTWEAKの発現は突出していることがわかった。TWEAKはTNFスーパーファミリーに属する炎症性サイトカインで、乾癬からADまで皮膚炎症でも主役ではないが炎症全体を調節するサイトカインとして知られている。とすると、この結果は乾癬の治療としてTNFやIL-17を抑えた結果、それまで目立たなかったTWEAKが主役に躍り出たのがPEである可能性を示している。事実、TNFやIL-17はTWEAKの発現を抑えることも示している。
ADでもTWEAK発現は上がっているが、PEではそれを超して発現上昇が見られ、特にM2マクロファージや cDC2と呼ばれる樹状細胞で強い発現が見られる。そして、組織上での空間トランスクリプトームにより、TWEAKを発現する白血球が、受容体を発現しているケラチノサイトと相互作用していることがはっきりとわかる。ADと比べた時TWEAK陽性の細胞浸潤がPEでは強いのがわかる。一方、ADで強く誘導されているFN14はPEでは低い。従って、ADとPEははっきりと区別出来る。Th2型の反応で見られるIL-4やIL-13はPE、ADともに発現している。以上の結果からPEの炎症の主役はTWEAK+IL-13などのTh2型サイトカインということがわかる。
この可能性を培養ケラチノサイトを用いて検証している。期待通り、ケラチノサイトにTWEAKとIL-13を合わせて刺激したとき、強いインターフェロン反応性の遺伝子の上昇が見られ、これが皮膚の強い湿疹状態を作っていることがわかった。
以上の結果をまとめると、TNFやIL-17を抑制することで、それまで抑えられていた白血球でのTWEAKが上昇するが、この時何らかのきっかけでTh2型炎症が合わさると、TWEAK+IL-13という、通常はあまり見られないサイトカインの組み合わせが発生し、PE特有の皮膚炎症を誘導するというシナリオが示された。
よく考えると、この一つの炎症治療が他の炎症を生み出したというパラドックスは、結局生命の複雑性を捉えきれない医学が何度も経験していることの一例に過ぎないといえるだろう。とするとパラドックスというのは正しい名前とは言えない気がする。
2026年11月8日
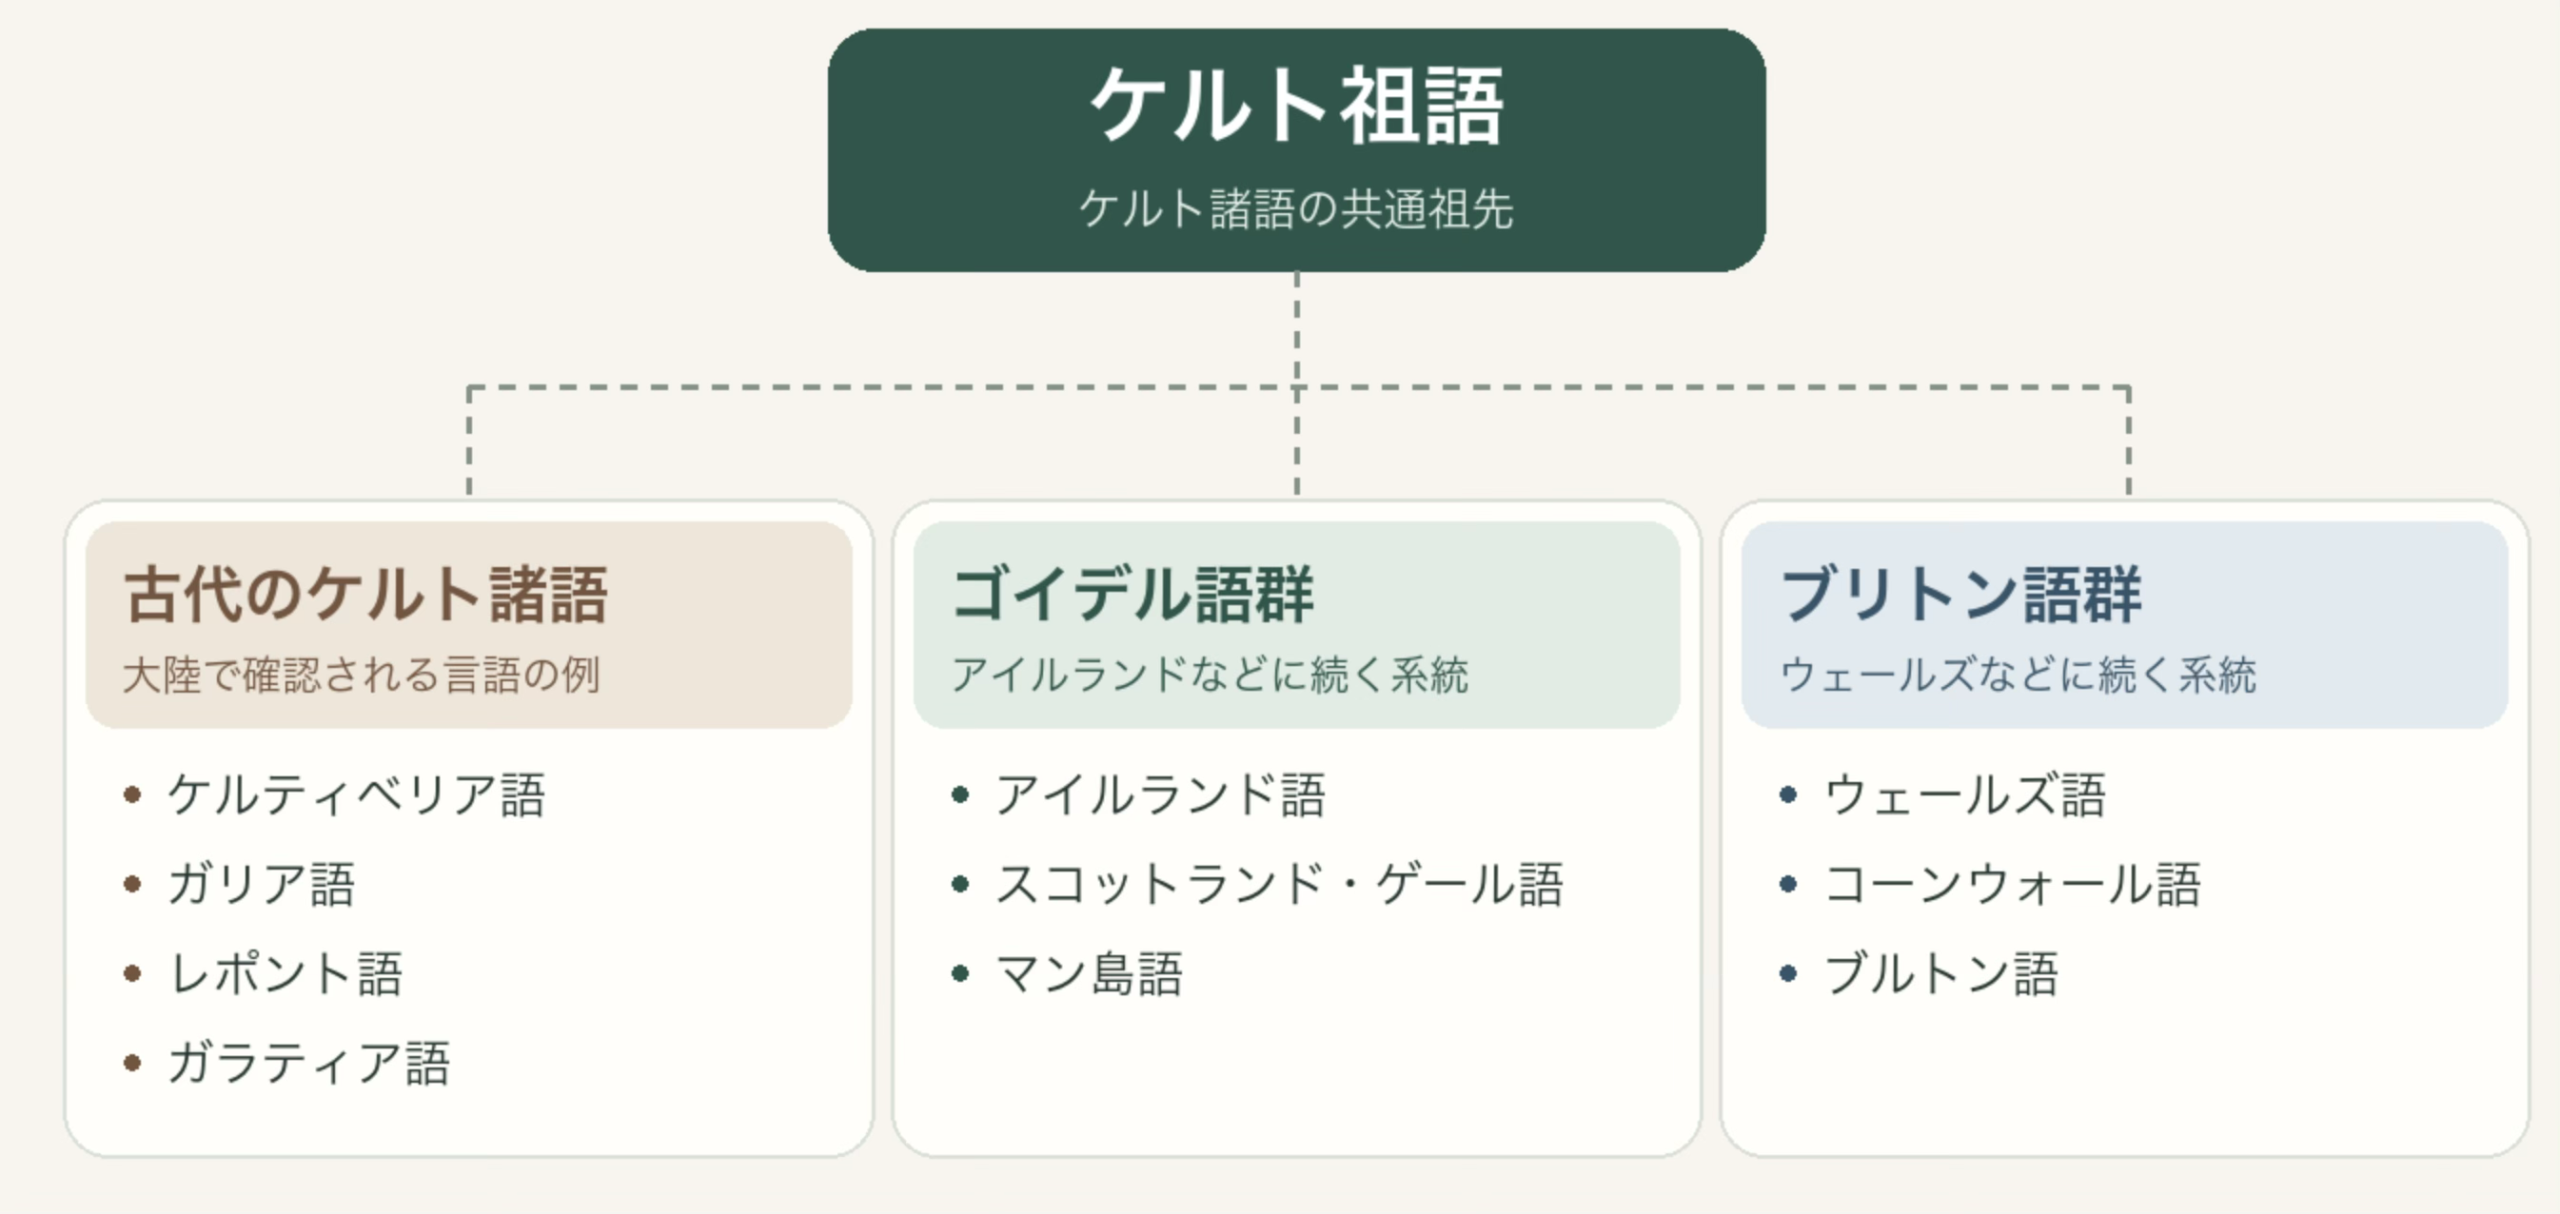
ヨーロッパ言語は、ロマン語、ゲルマン語、スラブ語が中心で、全てヤムナ文化に発するインドヨーロッパ語から分岐しているが、この論文を読むまでアイルランドやウェールズ語が属するケルト語が最初はヨーロッパの中心言語であったことを知らなかった。GPTにケルト語に属する言語をリストして貰うと図のようになる(検証していないが)が、実に多くの、私も初めて聞く多くの言語がケルト語を祖先とすることがわかるが、最初古代ケルト語として大陸に存在していたのに、現在ではほとんどヨーロッパの辺縁に追いやられている。
今日紹介するコペンハーゲン大学からの論文は、3000年前頃にインドヨーロッパ語から形成されたと考えられるケルト語が、どこで形成され伝搬したのかを、現在進むヨーロッパから出土する古代人のゲノムデータから解析した研究で、11月4日 Nature にオンライン掲載された。タイトルは「Tracing the spread of Celtic languages using ancient genomics(ケルト語の伝搬を古代人ゲノムを用いて追跡する)」だ。
言語の数学的比較から、ケルト語は4500年前にインドヨーロッパ語の方言として形成され、その後3500年前にケルト祖語として確立したと考えられている。また、大陸でガリア語などが話されていたことは記録として残っている。ただ、ヤムナ文化が北に移動してインドヨーロッパ語方言としてベル・ビーカー文化に生まれた後ヨーロッパに伝搬したのか、フランスやドイツを含むヨーロッパ中央部で形成され伝搬したのか、あるいは東欧起原か、様々な説が提唱されていた。
この研究ではヨーロッパで様々な時代に起こった民族の移動を古代人ゲノムから解析して、ケルト語が発生した3200年前の前後に起こった移動に最も合致する民族移動を探し、最終的にボヘミア、ババリアで生まれたKnoviz文化の西方への移動が、ケルト祖語の形成以降で起こり、その後ケルト語が使われた地域と合致することを確認している。
例えば、ベルビーカー文化とともに伝搬したと考えると、この文化の移動時期が4400-4200年前で、ケルト祖語の形成以前に Knovíz-related ancestry なってしまって、確かにヤムナ文化の移動に伴いケルト祖語以前に形成された方言が移動したと考えても良いが、各地域で同じケルト祖語が発達されたとは考えにくい。
その意味で3200年前から2800年前に行われたKnoviz文化の移動は、ゲノムのケルト語圏への移動と一致しており最も確率が高いことになる。ただ、著者らは実際のケルト語の伝搬はKnoviz民族移動よりもう少し大きな規模で起こったと考えている。即ち、ハンガリー・セルビアから移動したUrnfield文化の移動がケルト語伝搬の中心だが、この文化は火葬文化なのでゲノムが残っておらず、その文化の一部でゲノムの残るKnoviz文化をこの研究では指標として使ったと述べている。
以上が結果で、これまで文化系とされてきた言語学も総合科学として発展していることが感じられる。若かったら言語研究に進んだろうなと思うが、今はその進歩を楽しむことにする。
2026年11月7日
2024年に読んだ論文の中で一番印象に残っていたのはニューヨーク大学から Science に発表された論文で、ヘッドカメラを付けた幼児の見た画像と聞いた言葉を Transformer にインプットすると、子供と同じように LLM に言葉と画像の対応関係が生じたという研究だった。即ち、経験を続ける脳内を解析する代わりに、同じ経験を LLM で再現して言語発達過程を研究する可能性を示した研究だった。正に自分と同じ経験をしたアバターを作れるということが示されたと感心した。
今日紹介するプリンストン大学からの論文は、幼児が毎日聞く音の中から言葉の音素と単語という形態を抽出して扱う過程を、一人の幼児が1000日という長い期間で経験したスピーチを取り出してインプットすることで、子供と同じように LLM も言葉の音素や単語を学習できることを示した研究で、11月5日 Science に掲載された。タイトルは「The first 1000 days: Modeling language learning from individual children’s everyday speech(最初の1000日:個別の子供の毎日のスピーチから言語学習をモデル化する)」だ。
かなり大がかりな実験で、子供の暮らす家庭にビデオカメラとマイクロフォンを仕掛け、子供がいる場所で聞いたと思われる人の声を記録し、これを Transformer システムを備えた LLM にインプットしている。ただインプットが並大抵ではない。8人の子供の個別の体験をインプットしているが、成長と合わせて、総インプット量はそれぞれに異なる。最大で6600時間分、最少で1921時間になっている。さらに、様々な音の中から言葉だけを抜き出して、もう一度音に直してインプットしている。もちろん成長時期に応じてインプット量を増やして子供の経験に近づけている。そして極めつけはそれまでに聞いたスピーチを、最近の経験ほど高い確率で選んで、繰り返して聞かせている点で、これを replay と呼んでいる。Replay は眠っている子供が脳内で経験を繰り返すことで記憶の固定化が進むことを頭に置いて行っているが、その意味は今後の研究が必要だ。
学習させたモデルは音としてインプットされたスピーチを、20msの分解能で離散化、768次元の空間に分布させるエンコーダーと、インプットされた speech に対して次のアウトプットを予測するデコーダーから出来ている。またエンコーダーとデコーダーの学習率を変えるなど、子供の成長を考慮したかなり凝った学習が行われているが割愛する。
さて評価は、我々が LLM と付き合っているように、問いかけに答えたかと言う評価ではなく、言葉の音素を学習できたか、word form (=単語の音の形) を学習できたかを調べている。この場合英語に現れる音素を区別して(例えばPinとBinで/P/と/B/)、意味とは別にPinを一つの単語として認識できたかを評価している。方法だがかなりややこしい。音素については作成された speech をエンコーダーが離散化させた各ユニットに、文章に含まれる音素を正確に対応させたかどうかを調べて評価している。一方 Word form についてはデコーダーから次の speech unit がアウトプットされるかで評価しているが詳細は省く。
結果だが、同じ体験をした幼児と同じように、時間とともに学習した音素及び Word form の数が増えていくことが示され、また幼児間の多様性も反映されることが示されている。すなわち学習する量に応じて能力が上昇していく。驚くのは replayで、何度も何度も同じspeechを繰り返してインプットすることで、word formの数は急速に増加する。ただ、このreplay がヒトや動物で見られる海馬での記憶の固定化を意味するかはわからないと言っておいた方がいい。いずれにせよ、transformer 型の AI学習に replay が有効であることはわかった。
結果は以上で、幼児の体験を LLM に再現するという意味では重要な研究で、音体験を学習するだけですくなくとも英語に必要な音素を区別し、word form も区別出来るようになることはわかった。注意が必要なのは、体験の主体となった幼児と LLM を比較しているが、幼児の方は視覚を含む様々な体験が加わった学習である点だ。一方、LLMの方は音以外のインプットはない条件で行われている。この条件は一見ネガティブに見えるが、実際には人間で出来ない実験、即ち音感覚しか無いときの言語学習と言った状況を再現できるので、将来に期待できる。
残念なのは、768次元の12層ニューラルネットで、アテンションヘッドもあることから、呼びかけに応じてそれまで学習した文章をアウトプットすることも原理的には可能に思えるが、今回はこの可能性は全く追求されていない。これが可能になると、聴覚しかない状況で得られる言語学習の研究ももっと進むように思う。いずれにせよ、体験をLLM に移す研究はますます盛んになると思う。
2026年11月6日
これまで自閉症スペクトラム (ASD) のリスク遺伝子については何度も紹介してきた。しかし、それぞれの遺伝子がASD発症にどう関わるのかは、症例ごとに調べるしかない。また、ASDが一つの遺伝子変異で起こるケースは少なく、通常症状への寄与の少ないコモンバリアントと、寄与の大きいレアバリアントが集まって作用するため、症例ごとにバリエーションが大きく、なかなか共通項を把握できない問題があった。
今日紹介するハーバード大学からの論文は、正常の iPS細胞に由来する神経幹細胞や脳オルガノイドを用いてリスク遺伝子を欠損させることで、ASDリスク遺伝子が及ぼす共通の異常を把握しようとした研究で、11月4日 Nature にオンライン掲載された。タイトルは「Transcriptomic convergence and the female protective effect in autism(自閉症での転写の共通性と女性の発症を抑える効果)」だ。
この研究は以下のような仮説に基づいている。遺伝子変異はまず細胞レベルで表現されるが、その表現形をASDのような脳の複雑な過程と連結させるのは簡単でない。しかし、ASDと言う最終的な表現形に共通性が見られるなら、それぞれのASD関連遺伝子の変異が細胞に及ぼす変化にも何らかの共通性が認められるはずだというアイデアだ。
これを確かめるため、比較的リスクが高いASD関連遺伝子を18種類選んで、それぞれをヒトiPS細胞から誘導した神経幹細胞でノックダウンし、24時間後細胞に起こった遺伝子発現の変化を調べている。この24時間というのがミソで、これまでは変異の長期効果を見る実験が多かったが、その結果2次、3次と様々な変化が起こってしまい、変異の直接効果を見失う危険があった。
結果は予想以上と言え、18種類のうち15種類の遺伝子ノックダウンで変化する遺伝子の多くが自閉症リスクと相関することがわかっている遺伝子である事がわかった。例えば知能発達障害だけが誘導されることが知られている遺伝子を同じ条件でノックダウンしても、自閉症リスク遺伝子は変化しない。以上の結果から、自閉症リスク遺伝子の変異は自閉症リスク遺伝子をより選択的に変化させることが明らかになった。
次にノックダウンで細胞自体の活動がどう変わったのかも調べている。50%の遺伝子ノックダウンではっきりと細胞の増殖が低下する。一方増殖が上昇する遺伝子も一つだけ存在していた。このように細胞レベルの形質変化を自閉症の脳発達治験と結びつけるのは難しい。そこで今度は脳のオルガノイドを用いてより詳しい形質変化を追いかけている。このための実験はかなり凝っており、18種類の遺伝子ノックダウンを可能にした iPS細胞を全て混合してオルガノイドを形成させることで、増殖できなくてすぐにオルガノイドが消滅することを避けている。その上で、ノックダウンがうまくいった細胞は蛍光標識でソーティングし、single cell RNA sequencing で個々のノックダウンの影響が見られるように設計している。
最初はノックダウン後十分時間を経た後の結果だが、神経幹細胞だけでなく、オルガノイド内で分化した細胞でも、ASD遺伝子ノックダウンがASD遺伝子をより選択的に変化させていることを確認している。また、細胞の形質としては興奮神経細胞が増え、未熟細胞が減少することが観察された。さらにノックダウンをオルガノイド形成後に誘導して、急性反応を調べる実験も行っている。この実験系では様々な神経細胞で同時に遺伝子ノックダウンが起こるが、特に興奮神経では神経幹細胞の急性ノックダウン実験で観察したのとほぼ同じ自閉症リスク遺伝子が影響を受けることが明らかになった。
後は変化する遺伝子の中で、転写のハブとして多くの下流遺伝子を変化させるCHD8やREST遺伝子についてより詳しい解析をして、遺伝子ノックダウンがこれらの転写遺伝子を介して、多くのリスク遺伝子を動かしている可能性を示している。CHD8はASDリスク遺伝子変異としては頻度が高く、多くの標的遺伝子のクロマチンリモデリングに関わる分子だし、RESTも多くの標的のマスター調節因子として神経分化を抑える分子で、例えばCDH8やMECP2のようなASDリスク遺伝子を調整することが知られている。このように、今回ノックダウンに選んだASDリスク遺伝子は、RESTやCDH8の発現量に強く影響することで、下流にある多くのASD遺伝子を調節する可能性が示された。
最後に、影響を受けるASD遺伝子のネットワーク解析から見つかったX染色体上のZFXについても解析を行っている。ZFXはASDで発現が低下することが報告されており、今回の遺伝子ネットワーク解析と一致する。おもしろいのはZFXが不活化されたX染色体からも転写されることで、女性では男性の倍のZFXが転写されていることになる。すなわち、ZFX転写の低下がASD発症に重要だとすると、男性の方が異常が起こりやすく、ASDが男性で多いという事実を説明できる。
以上が結果で、一つ一つの遺伝子の解析ではなく、ASDリスク遺伝子は大きなネットワークを形成しており、一つ遺伝子の発現変化が多くのASDリスク遺伝子の変化につながるというシナリオを強調する論文だと思う。即ち、多様なASDリスク遺伝子を共通のネットワークとして捉えることで、ASDと言う多様な表現系の背景の共通性が理解できるという話になる。
2026年11月5日
最初16SリボゾームRNAシークエンシングから始まった細菌叢研究も、現在ではショットガンシークエンスとゲノム再構成によるよりリアルな細菌ゲノムを求めるようになり、場合によっては long read のシークエンサーで完全なゲノムを特定する試みまで進んできた。
そんな中で今日紹介する米国MITとドイツキール大学からの論文は、ゲノムから細菌を再構成するメタゲノムと実際に細菌を培養して得られる情報を丁寧に比べて、リアルな細菌培養の重要性を示した研究で、11月2日 Cell にオンライン掲載された。タイトルは「Convergent genomic evolution of human gut bacteria along an industrialization gradient(工業化に伴うヒト腸内細菌ゲノムの収束的進化)」だ。
これまでの多くの研究で、我々人間の腸内細菌叢は工業化とともに大きく変化していることがわかっている。このグループも、同じ時に工業化により細菌叢の多様性が失われ、腸内での免疫反応を反映するIgA分泌が高まり、腸内での炎症ストレスが上昇していることを発表している。このこと自体は新しい発見とは言えないが、工業化国の細菌叢が他の人に移植しやすいというおもしろい結果を示している。即ち、細菌の多様性は減ったが、細菌自体の人間への適合性が高まったことを示唆している。
この適合性の上昇という工業化に伴う細菌側の進化を研究するためには、細菌をリアルに培養する必要がある。この研究では、選択性が少ない培地を用いて得られた細菌叢に含まれる各細菌を培養、個々の細菌ゲノム配列を決定するとともに、同じサンプルで培養前の細菌叢のゲノムを再構成するメタゲノム解析をおこなって、それぞれの方法を比べている。
個々の細菌の構成で見ても、工業化によって株レベル、種レベルの多様性が低下していることなどは捉えることが出来るが、この研究では10種類の異なる株をひとまとまりの集団として扱って、メタゲノム解析と個別のゲノムの解析とをいろいろ比べている。
まず、メタゲノムで細菌ゲノム再構成技術は進んできているが、しかし分離細菌のゲノム解析と比べると、多くの遺伝子が失われていることがわかる。驚くことにゲノムサイズで見るとメタゲノム再構成では実際の半分程度に低下する。特に、水平遺伝子伝搬でゲノムに統合された遺伝子をメタゲノムではほとんど把握できない。
今回初めて明らかになったのは、工業化で確かに細菌叢の多様性は失われるが、細菌の合成するタンパク質は全ての種で工業化とともに上昇する事がわかる。即ち細菌自体が工業化とともにより進化し、人間に適合している可能性が示唆された。さらに、水平遺伝子伝搬などによるゲノムの可塑性は工業化とともにはるかに高まっている。そして、このような変化をもたらすほとんどは、水平遺伝子伝搬と、遺伝子自体の変異によっていることも確認している。おそらく long read sequencing を用いれば同じ結果を得ることは可能だと思うが、正に培養して個々のゲノムを調べることの重要性が良くわかるデータだ。
その上で、同じ種の細菌自体が工業化により異なる遺伝子構成を進化させていることも、工業化で増大した、あるいは減少した遺伝子から推察することができる。工業化で増加する遺伝子で目立つのは、ホスト自然免疫と相互作用する細菌細胞壁構成分子や、アミノ酸の分解に関わる分子で、今後細菌培養を用いた進化の再現実験も可能だろう。おもしろいのは、工業化により異なる種の相同遺伝子で同じ変異が起こることで、工業化というホストの状況により細菌のゲノムが自然選択されることがわかる。
以上が結果で、工業化国の人間の細菌叢が他の人間に移植しやすいという、この論文に先行する発見を、細菌自体のゲノム進化として見事に説明している。なんと言っても、この研究で調べられた細菌はライブラリーとして全て残っている点で、今後これを用いて細菌叢操作につながる重要な研究が進むように思う。
2026年11月4日
SLEは、DNAや様々な核内タンパク質に対する自己抗体を特徴とし、全身の臓器が傷害される自己免疫疾患だが、まだまだ謎が多い。間違いなく自己に対するT細胞も反応していると考えられ、例えば活性化されたトランスポゾン抗原などが抗原として報告されているが、T細胞反応を誘導するペプチドの特定は病態理解のために必須だ。
今日紹介するワシントン大学からの論文は、SLEの白血球で特異的に見られるスプライシング異常によって生成されるネオ抗原ペプチドが SL のT細胞反応の重要な抗原として働いていることを示す研究で、10月28日 Nature にオンライン掲載された。タイトルは「T and B cells recognize splicing-derived neutrophil neoantigens in lupus(SLEの好中球のスプライシング異常により生成されるネオ抗原はT細胞とB細胞により認識される)」だ。
タイトルにあるネオ抗原という言葉は、このブログでもガン免疫を誘導する抗原として紹介してきた。ガンで起こる様々な変異は、自己のタンパク質とは異なる外来抗原として認識され、ガン免疫誘導には必須の要因だ。一方、自己免疫と言うときは変異のない自己抗原が免疫反応を誘導すると考えており、変異を持つネオ抗原の生成は考慮されてこなかった。
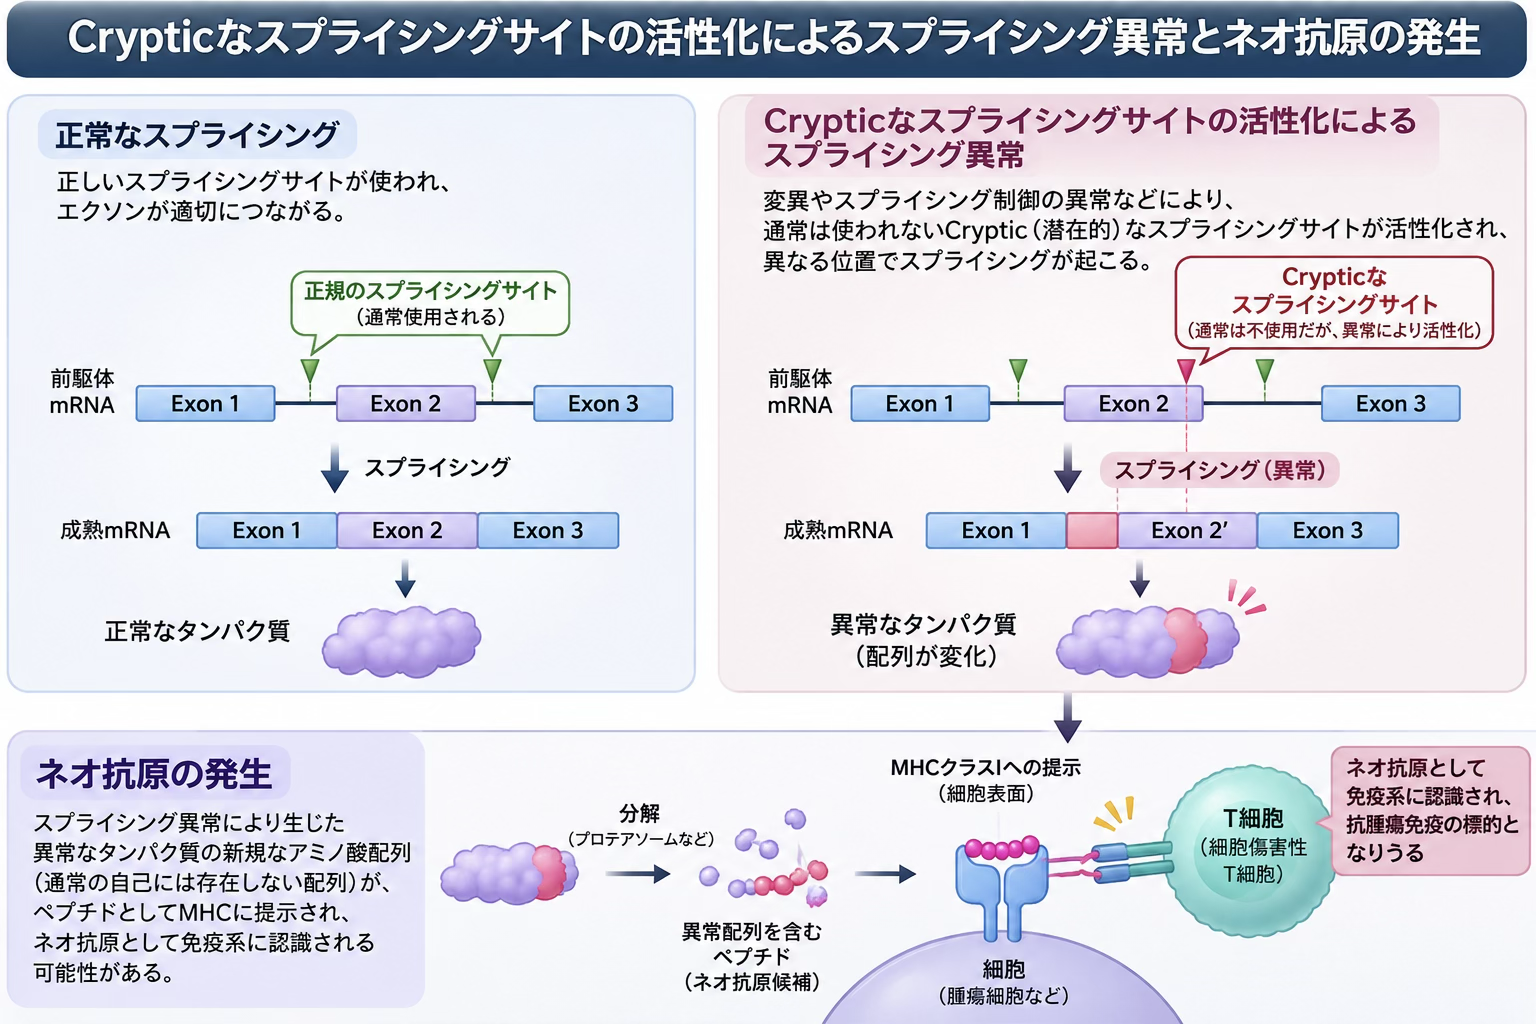
この研究では、一種の研究のカンで、SLEで異常が起こりやすい好中球でスプライシングの異常が起こることで通常存在しない遺伝子配列が生成され、これが抗原として免疫反応を誘導するのではと狙いを付けて、SLE患者さんから好中球を集めRNAシークエンスを元に、スプライシング異常、即ち本来ならスプライシングのシグナルにならない配列を間違ってスプライシングシグナルと認識してしまって発生する異常RNAを探索した。
結果は予想以上と言って良く、SLEの好中球だけでスプライス異常によるネオ抗原を生成できるmRNAが生成されていることがわかった。スプライシングは300近いタンパク質で調節されているが、何らかのきっかけでSLEでは好中球でスプライシング分子の発現異常が起こることがわかった。同じような異常はリューマチ性関節炎でも全く見られないことから、かなりSLE特異的と考えられるが、この点についてはこれからの研究が必要になる。
重要なのは、この異常は決まった異常mRNAを合成するのではなく、細胞ごとに、それもその時々でランダムに様々な異常mRNAが合成されることだ。また異常が起こる遺伝子の多くはインターフェロンで誘導されるものが多いが、それ以外の遺伝子でも起こる。そして出来てくるペプチドはT細胞抗原として十分働きうる長さのペプチドが造られることがわかった。
いくつかの遺伝子については、どの配列がスプライシングシグナルとして認識され、どのような新しいペプチドが産生されるのかも確かめている。またこれらがT細胞を刺激するネオ抗原ペプチドとして働いている可能性をさらに調べるために、SLE患者さんの好中球からMHC分子を生成し、これに結合しているペプチドの配列を解析して、RNA配列から予想される新しいペプチドの一部がMHCと結合していることを明らかにし、スプライス異常で発生したペプチドの持つネオ抗原がSLEでT細胞を刺激する可能性を示している。ここまでの過程をGPTにイラストとしてまとめさせると以下のようになる。
実際に起こっているスプライス異常は図のような単純なものではなく、様々なタイプのスプライシング異常が起こっているが割愛する。
そしてこれらのネオ抗原に反応するT細胞が増殖し機能している証拠を、患者さんからのT細胞をいくつか選んだネオ抗原ペプチドに対する反応を指標に確認している。結果はインターフェロンの活動が高いSLE患者さんで特にT細胞の反応が認められること、またCD8、CD4T細胞とも反応していることを確認している。そして、CD8T細胞がキラー細胞として好中球に作用している証拠も示している。
この研究では、T細胞反応だけでなく、スプライス異常で発生したペプチドに対して自己抗体も検出できることも示して、スプライシング異常によるネオ抗原発生がSLEの自己免疫反応の最も重要な背景にあると結論している。
SLEの場合遺伝子変異は必要無いので、ガンのネオ抗原とは少し違うが、しかし自己ゲノムから免疫系の経験したことのない抗原が産生されるという点でネオ抗原と言ってもいいだろう。ただ、このメカニズムがSLE発症のどの位置にあるのかは今後の研究が必要だと思う。是非追求していってほしいアイデアだ。